P50, P95 e P99: percentis e a latência que a média esconde
Entenda P50, P90, P95 e P99, encontre a lentidão escondida pela média e aprenda a medir latência, agregar histogramas e definir metas para sua API.
performance
observability
system design
latency
sre
Ednaldo Luiz
Nível: Intermediário
Nível:
Publicado:
Última atualização:
14 min de leitura
visualização: - visualização
Introdução
O suporte avisa que finalizar uma compra está demorando. Você abre o dashboard do checkout: tempo médio de resposta perto de 120 ms.
Parece rápido. Então por que há gente esperando segundos?
As duas informações podem estar certas. A maioria das requisições termina depressa, enquanto uma parcela encontra um caminho muito mais lento.
Parte dessa diferença não está na infraestrutura, está nos dados. O mesmo endpoint faz mais trabalho para o cliente que tem dez vezes mais pedidos. A requisição é a mesma; o volume que ela atravessa, não.
Ao resumir tudo em uma média, essa diferença perde destaque.
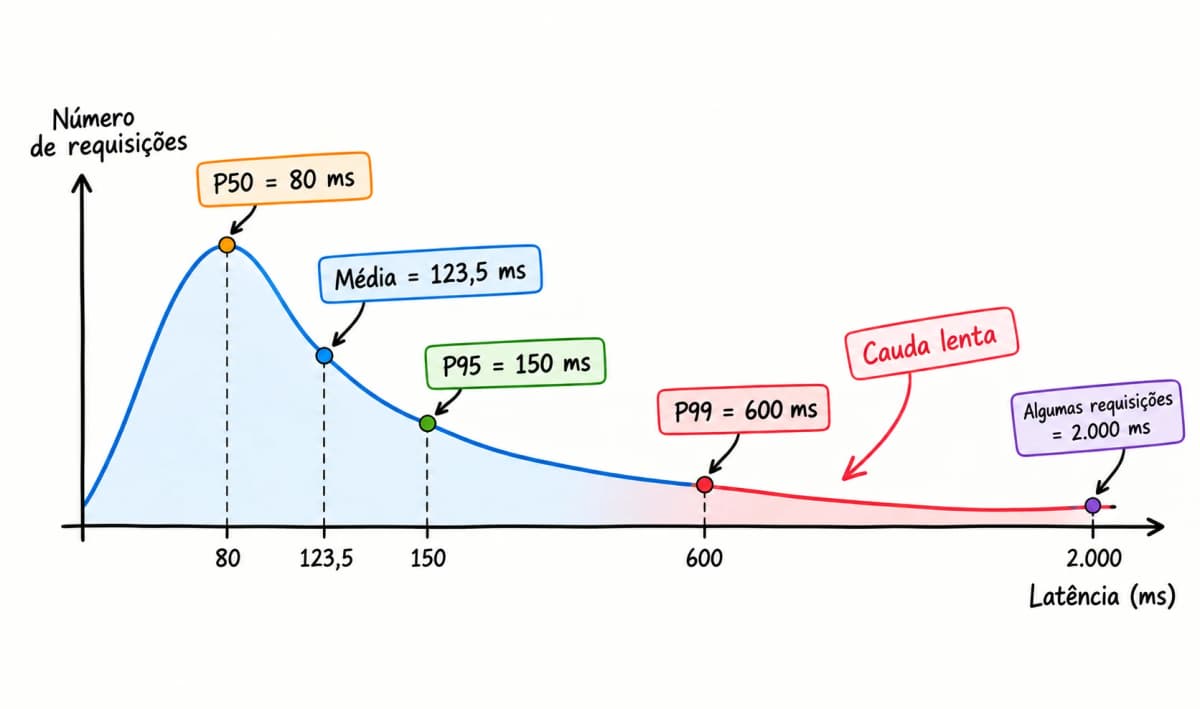
É para enxergar essa distribuição que usamos percentis de latência, como P50, P95 e P99. Eles ajudam a separar a experiência mais comum da cauda: as requisições que demoram mais.
Só que trocar a média por um painel de P99 não encerra o problema. Também precisamos saber o que foi medido, como os dados foram agregados e o que aquele número permite concluir.
TL;DR
P50 mostra a mediana; P95 e P99 ajudam a observar a cauda da latência. Eles descrevem posições na distribuição, não porcentagens de melhora nem o pior caso.
Para usá-los bem, compare a mesma população e janela, agregue as distribuições antes de calcular percentis e leia os resultados junto com volume e erros.
O que significam P50, P90, P95 e P99
O P é de percentil, e percentis indicam posições em um conjunto de valores ordenados. No caso da latência, ordenamos os tempos de resposta do menor para o maior.
P95 de 250 ms significa, na leitura operacional, que aproximadamente 95% das observações ficaram em até 250 ms. O P50 corresponde à .
| Percentil | Posição observada | O que ajuda a enxergar |
|---|---|---|
| P50 | Metade da distribuição | O centro dos tempos de resposta |
| P90 | Até 90% das observações | Uma faixa mais lenta que a mediana |
| P95 | Até 95% das observações | A experiência perto dos 5% finais |
| P99 | Até 99% das observações | A experiência perto do 1% final |
Os dois jeitos de ler descrevem a mesma linha. Até 99% nomeia quem ficou coberto pelo valor; o 1% final nomeia quem ficou acima dele, que é onde a dor está.
O número depois do P define a posição. O valor associado continua na unidade medida: milissegundos, segundos ou outra unidade de duração.
Portanto, P99 = 600 ms não significa “99% mais rápido”. São dois números com papéis diferentes: 99 é a pergunta, o ponto da distribuição que você escolheu olhar; 600 ms é a resposta que os dados deram.
Outra distinção: percentil de requisições não é percentil de usuários. Uma pessoa pode fazer várias chamadas e aparecer muitas vezes na amostra. Não dá para concluir que “só 1% dos clientes sofreu” porque 1% das requisições ficou acima de um limite.
Para sair da definição, vamos calcular esses pontos em um checkout fictício.
Média e percentis na prática
Uma média de 123,5 ms pode conviver com requisições de dois segundos. O exemplo abaixo mostra exatamente como.
Considere 1.000 requisições bem-sucedidas ao mesmo endpoint, medidas na entrada da API durante cinco minutos. Os tempos são sintéticos e foram agrupados para facilitar a conta:
| Requisições | Posição na amostra ordenada | Latência de cada uma |
|---|---|---|
| 900 | 1 a 900 | 80 ms |
| 50 | 901 a 950 | 150 ms |
| 40 | 951 a 990 | 600 ms |
| 10 | 991 a 1.000 | 2.000 ms |
A média sai de somar as durações de todas elas e dividir pela quantidade:
Soma das durações
Requisições
Média
123.500 ms
1.000
123,5 ms
Soma das durações
123.500 ms
÷
Requisições
1.000
=
Média
123,5 ms
O cálculo está certo. Mas nenhuma requisição dessa amostra levou 123,5 ms. A média condensou quatro experiências diferentes, de 80 ms a dois segundos, em um único número.
Para calcular os percentis, usaremos uma convenção simples, chamada nearest rank: multiplique a fração desejada pelo tamanho da amostra, arredonde para cima e encontre essa posição na lista ordenada. Não é o único método; algumas ferramentas interpolam entre observações.
Para P95, a posição é 0,95 × 1.000 = 950. A requisição na posição 950 levou 150 ms. Repetindo a conta, temos P50 = 80 ms, P90 = 80 ms, P95 = 150 ms e P99 = 600 ms.
Veja onde o P50, o P95 e o P99 caem na amostra ordenada:
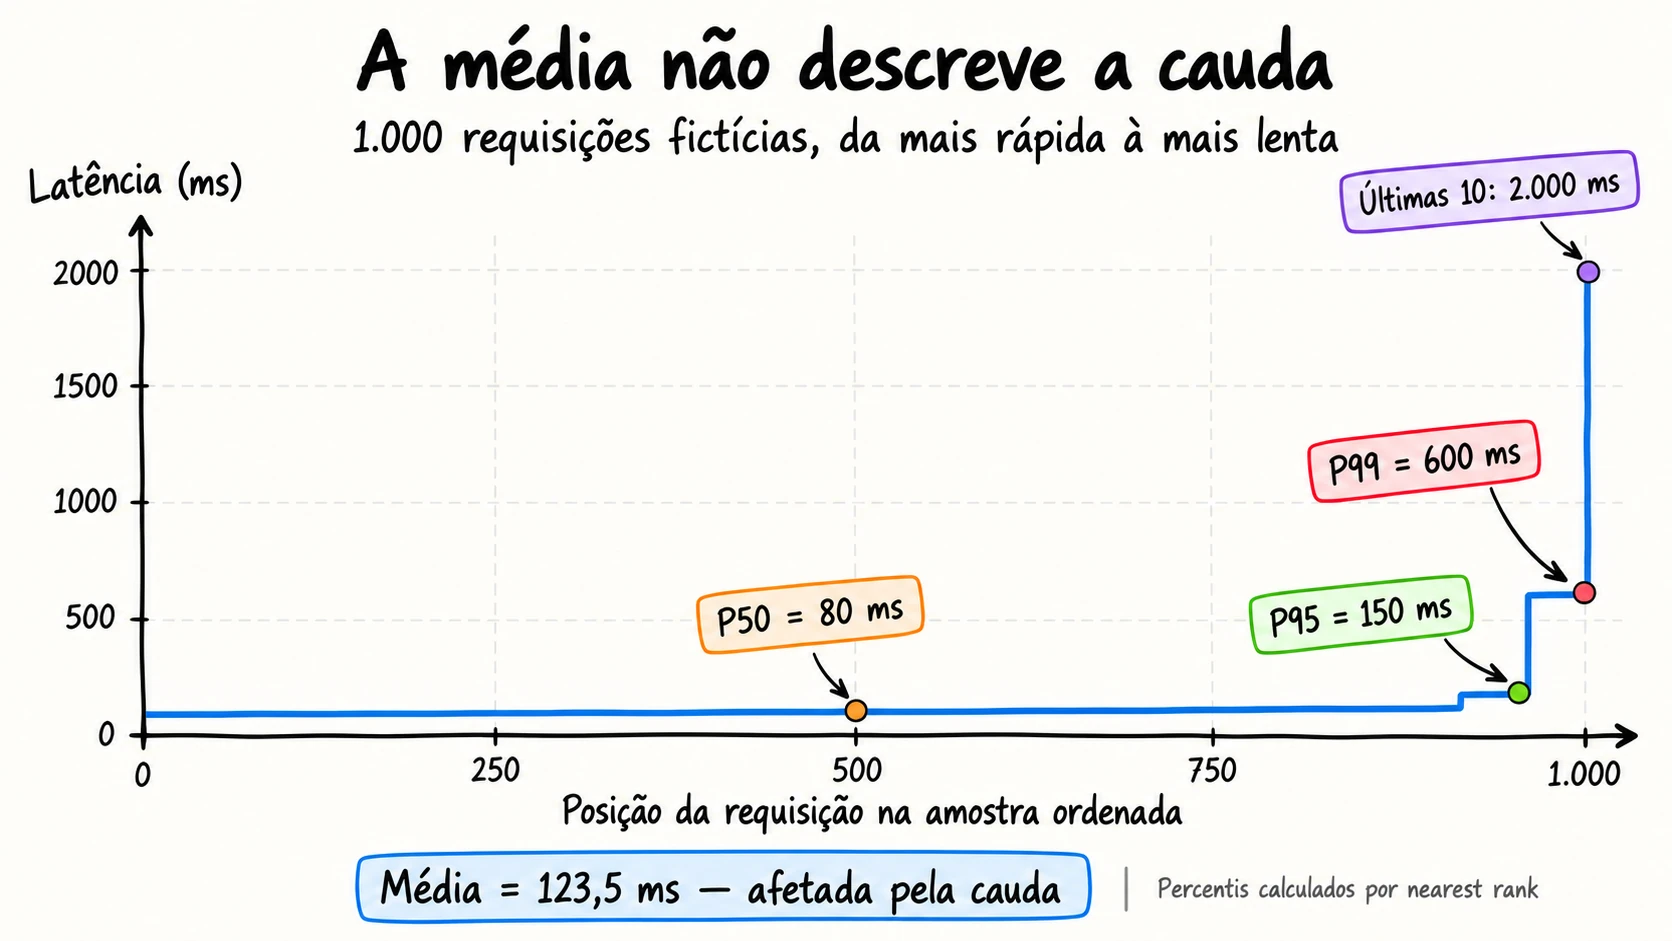
O eixo horizontal representa posições, não passagem do tempo. Depois do P99 ainda existem dez requisições, todas com dois segundos.
O P90 não está ali porque cairia no mesmo ponto do P50. Das mil requisições, 900 levaram 80 ms, então a posição 500 e a 900 apontam para o mesmo número. Não espere que quatro percentis devolvam quatro valores diferentes: onde há empate, eles coincidem, e isso é normal.
O gráfico também mostra uma limitação importante: P99 não é máximo. Se aquelas últimas dez requisições passassem de dois para dez segundos, o P99 continuaria em 600 ms pelo método adotado. A média subiria.
Isso não torna os percentis ruins nem a média inútil. Eles respondem a perguntas diferentes. A média resume o tempo por operação; os percentis mostram até onde precisamos avançar na distribuição para cobrir determinada parcela das observações.
E o P99.9? Ele fica na posição 999 das mil, que levou dois segundos. Mas 0,1% de mil é uma requisição, e uma requisição não é um padrão. Mais casas depois do P não inventam dado que ninguém coletou.
Até aqui a cauda foi um detalhe de uma amostra: dez requisições entre mil. Em um sistema distribuído ela deixa de ser detalhe.
Latência de cauda
Latência de cauda, ou tail latency, é a lentidão na parte final da distribuição. Em sistemas distribuídos, ela importa porque uma resposta pode depender de várias oportunidades de encontrar uma chamada lenta. É o problema que Jeffrey Dean e o brasileiro Luiz André Barroso descreveram em The Tail at Scale, na Communications of the ACM de 2013, e a conta que vem daqui a pouco é a deles.
Uma requisição rápida pode encontrar o dado no cache. Outra precisa consultar o banco, esperar uma conexão do pool ou disputar um lock. A mesma consulta pode até desviar do índice para um cliente só, porque ele preencheu um campo que os outros deixam vazio.
Pausas do runtime, filas e dependências externas também podem alongar apenas parte das chamadas. O percentil mostra o efeito, não qual desses mecanismos o provocou.
A forma dessa cauda é propriedade do sistema, não da métrica. Dois serviços em produção, em horário de pico, no mesmo painel:
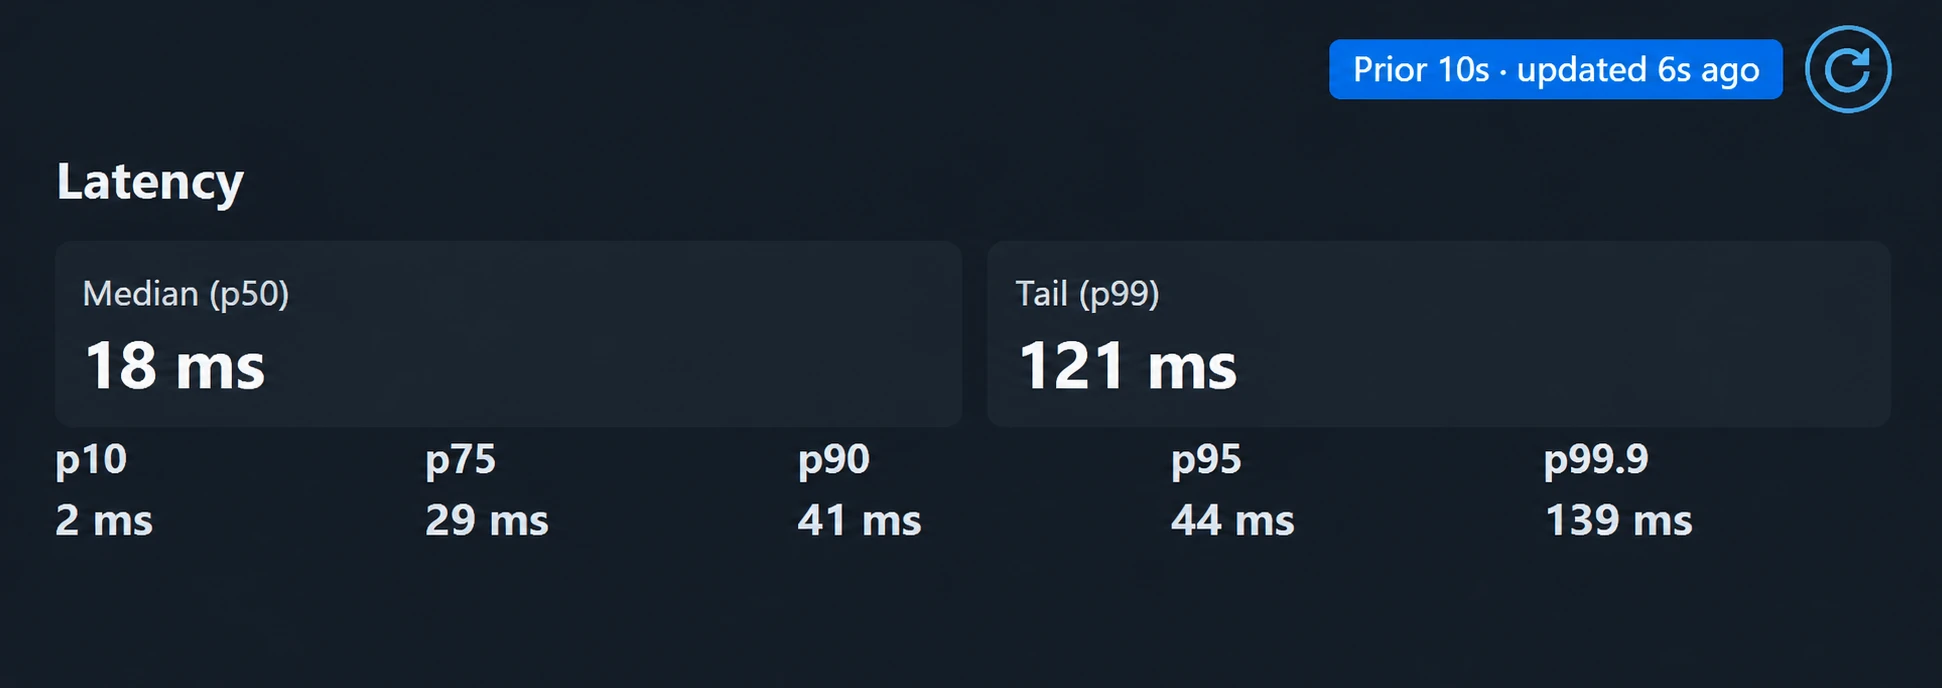
Do p10 ao p90 a latência anda devagar, e p90 e p95 quase se tocam: 41 e 44 ms. Entre p95 e p99 ela quase triplica. O salto não está espalhado, está nos últimos 4% das requisições. Serviço não identificado; os valores são os do painel no momento do print.
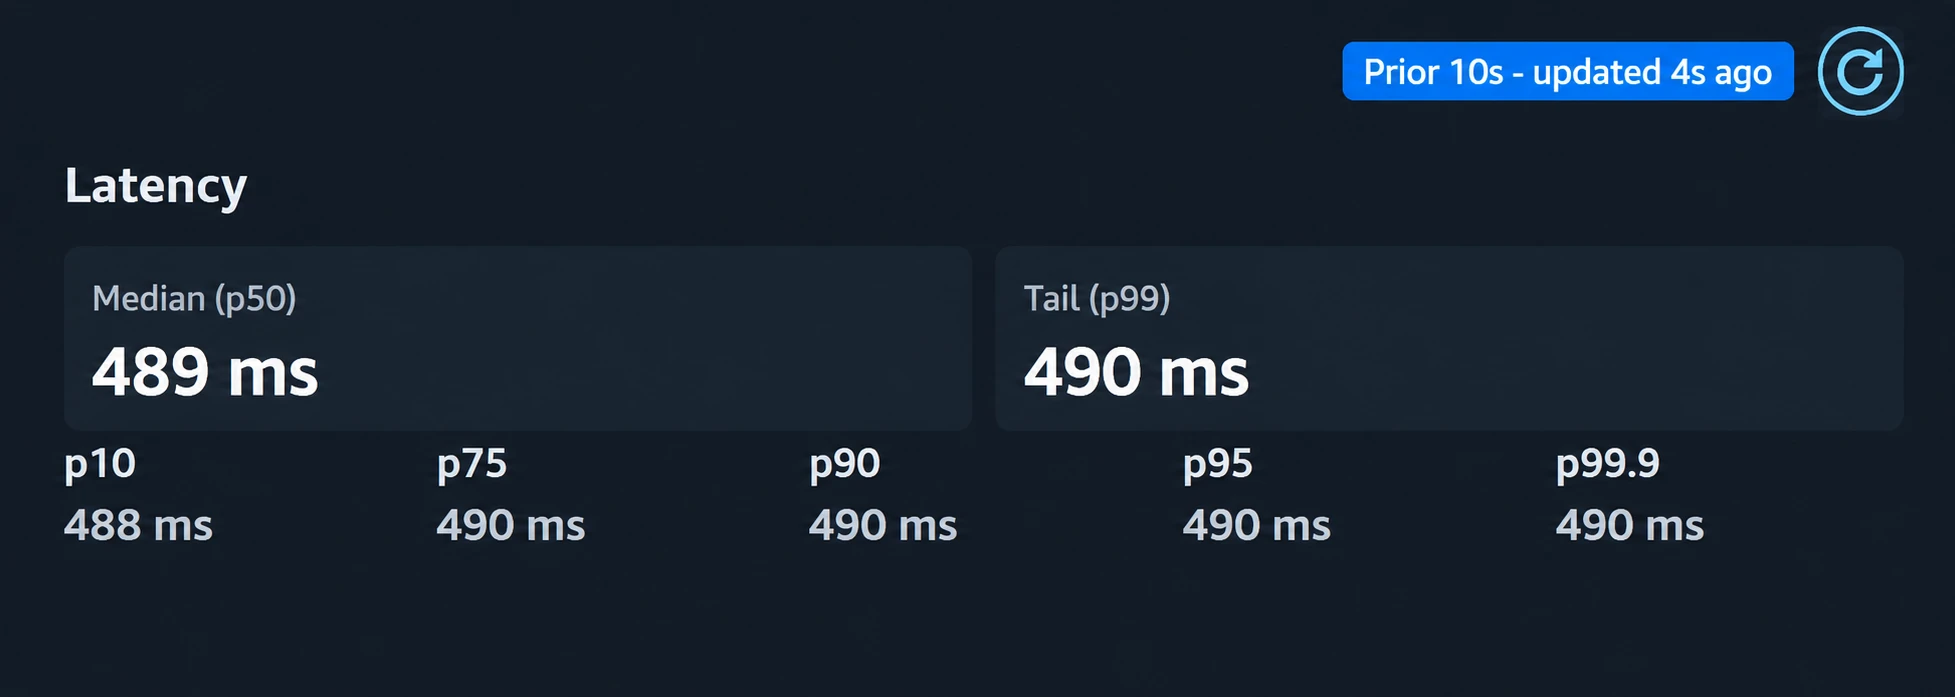
Do p10 ao p99.9, dois milissegundos de diferença. Aqui não existe cauda para a média esconder, e um gráfico disso seria uma reta.
Nenhum dos dois está errado. São sistemas diferentes, e é por isso que qual é um bom P99? não tem resposta fora do seu próprio painel.
Agora imagine uma tela que consulta várias dependências em paralelo e só termina quando todas respondem. Paralelizar evita somar as esperas uma a uma, mas não elimina a mais longa: a tela demora o que demorar a chamada mais lenta, mais o trabalho de juntar as respostas.
É o exemplo de Dean e Barroso: um servidor com P99 de um segundo deixa uma chamada em cada cem lenta. A conta fica mais fácil pelo avesso, calculando a chance de tudo dar certo e tirando do total:
1
Uma chamada sai rápida
0,99Se ela cai na faixa lenta em 1% das vezes, sai rápida nos outros 99%.
2
Todas as chamadas saem rápidas
0,99 × 0,99 × … = 0,99ⁿMultiplicamos porque todas precisam dar certo ao mesmo tempo, e o expoente é quantas chamadas a resposta precisa. A conta supõe que uma não influencia a outra.
3
Pelo menos uma sai lenta
1 − 0,99ⁿÉ todo o resto. Sai mais barato calcular o caso bom e tirar de 1 do que somar as combinações uma a uma.
4
Agora com cem chamadas
n = 100 → 0,99ⁿ = 0,366 → 1 − 0,366 = 0,634As cem saírem rápidas acontece em 36,6% das vezes, pouco mais de um terço. Todo o resto é a tela lenta: 63,4%.
O gráfico mostra como essa probabilidade cresce:
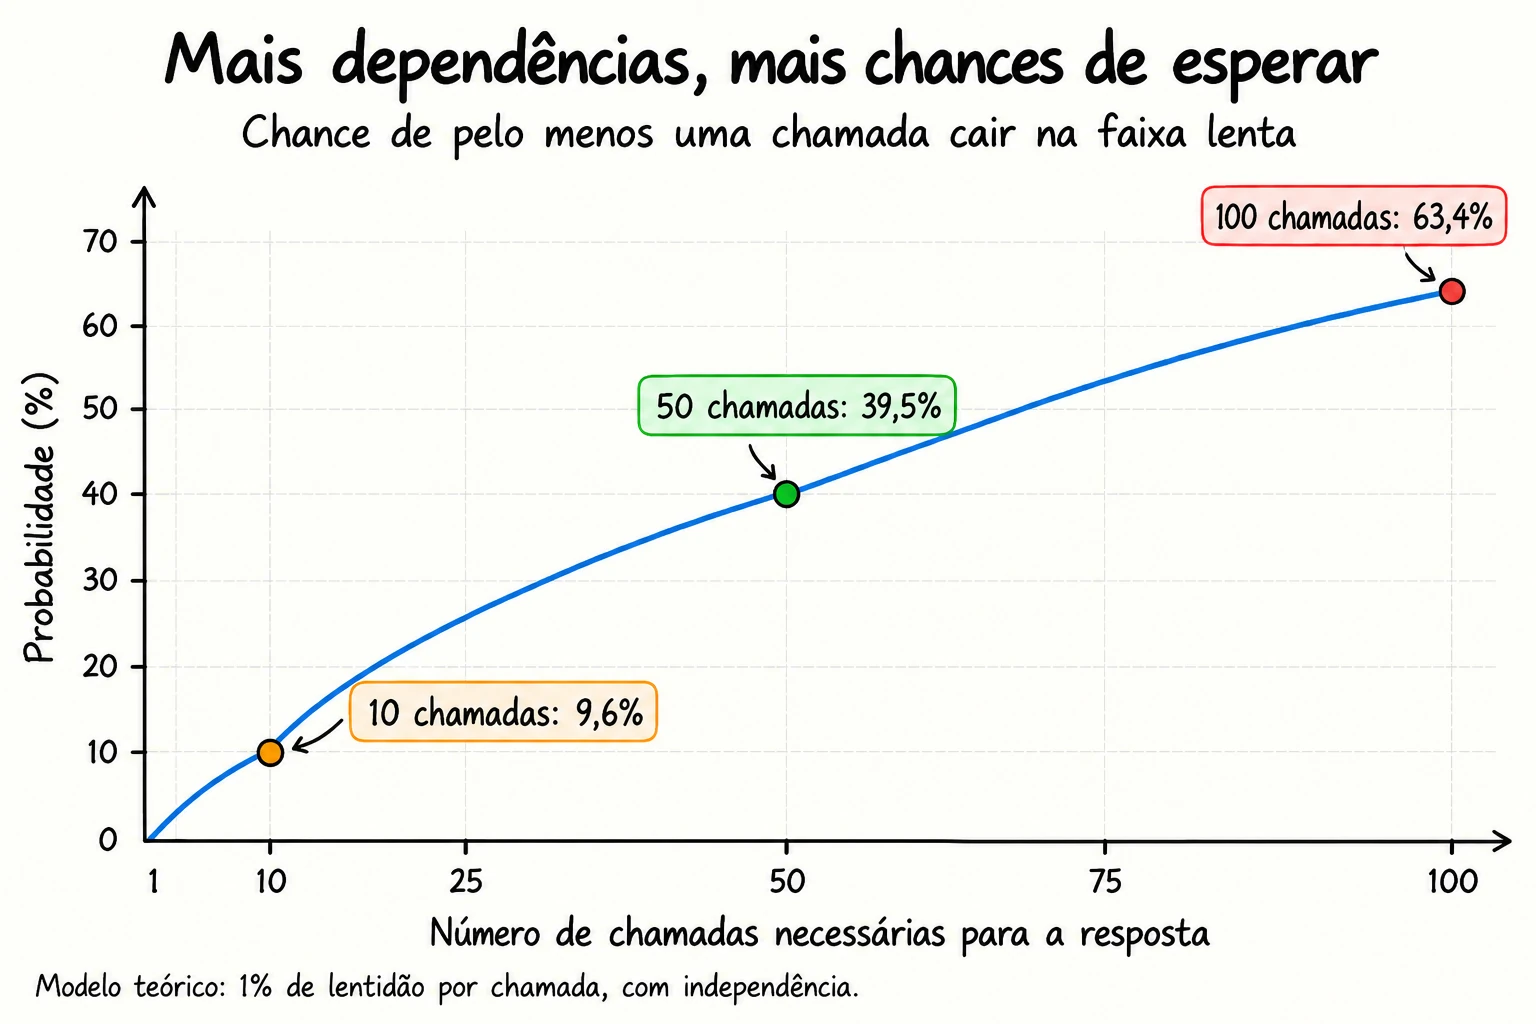
O cálculo assume chamadas independentes, todas necessárias, com a mesma chance de lentidão. Dependências compartilhadas e falhas correlacionadas mudam esses valores.
A exceção de cada chamada virou o caso comum da tela. Nada mudou no servidor: o que mudou foi quantas oportunidades a resposta deu para encontrar a cauda.
E não dá para somar os P99 dos serviços e chamar o resultado de P99 da jornada. Os eventos lentos podem acontecer em requisições diferentes ou coincidir. Meça a operação completa, além das chamadas internas.
A pergunta de design passa a ser concreta: a resposta precisa mesmo esperar por todas essas dependências? Um bloco opcional pode ficar fora do caminho crítico? A resposta depende do produto, não apenas da possibilidade técnica de disparar chamadas em paralelo.
Só que qualquer decisão dessas depende de confiar no número que está no painel. E produzir um P99 enganoso é mais fácil do que parece.
Como medir percentis sem distorcer o resultado
Um P99 precisa vir acompanhado de contexto: de quais operações, em qual janela, medido de onde e com quantas observações? Sem isso, dois dashboards podem exibir números diferentes e ambos estarem corretos.
Antes dos cuidados, uma ideia que organiza todos eles. Média, percentil e histograma não são três assuntos: são três resumos da mesma pilha de durações, e o que separa um do outro é o que cada um joga fora.
| Resumo | O que guarda | O que joga fora |
|---|---|---|
| Média | a soma e a contagem | tudo o mais |
| Percentil | um ponto da fila ordenada | a distribuição inteira |
| Histograma | quantas caíram em cada faixa | onde cada uma caiu na faixa |
A média não está em todo painel por descuido: ela é a mais barata das três. O serviço só precisa manter dois números na memória, um somador e um contador, e não guarda uma duração sequer. Descer na tabela custa mais memória e devolve mais informação, e é essa troca que decide o que o seu número consegue responder.
Preserve a distribuição antes de calcular
Em telemetria, um histograma registra quantas observações caíram em faixas de valores, chamadas buckets. Assim, não precisamos guardar cada duração individual para manter informação sobre a distribuição. O modelo de métricas do OpenTelemetry oferece Histogram e ExponentialHistogram para essa finalidade.
Essa representação tem um preço: o percentil pode ser estimado. Se uma faixa cobre de 250 ms a um segundo, sabemos quantas observações caíram ali, mas não suas posições exatas dentro dela. A resolução escolhida limita a precisão.
Isso explica por que uma ferramenta pode mostrar 487 ms e outra, 493 ms sem necessariamente existir um bug. Métodos e resoluções diferentes podem produzir estimativas diferentes; casas decimais não garantem exatidão.
Há um caso em que isso deixa de ser imprecisão e vira cegueira: quando o serviço é rápido demais para a régua. Buckets padrão costumam começar na casa dos milissegundos, mil vezes acima da escala de um serviço que responde em microssegundos, e aí ele joga tudo no primeiro bucket. O P99 para de se mexer e passa a parecer saudável justamente porque não enxerga mais nada. É para faixa assim que serve o ExponentialHistogram, que ajusta a resolução à escala dos dados em vez de exigir que você acerte as faixas antes de medir.
A média dos P99 não é o P99 global
Suponha duas instâncias do checkout na mesma janela. A primeira atende 10.000 requisições, todas em 100 ms. A segunda atende 100, todas em dois segundos. Cada uma reporta o seu P99, e a pergunta é qual número representa o checkout.
1
O P99 de cada instância
100 ms e 2.000 msDentro de cada amostra todas as requisições levaram o mesmo tempo, então o percentil é o próprio valor: 100 ms na primeira, 2.000 ms na segunda. São os dois números que chegam ao painel.
2
A média dos dois P99
(100 ms + 2.000 ms) ÷ 2 = 1.050 msSomar e dividir por dois dá o mesmo peso às duas instâncias. A que respondeu por 1% do tráfego entra com metade do resultado, e o número que sai não aconteceu com nenhuma requisição.
3
O P99 das 10.100 juntas
0,99 × 10.100 = posição 9.999 → 100 msOrdenadas, as 10.000 requisições de 100 ms ocupam da posição 1 à 10.000, e a 9.999 cai dentro delas. O P99 real é mais de dez vezes menor que a média dos dois.
A diferença entre 1.050 ms e 100 ms não é arredondamento. O primeiro número é a média de dois resumos; o segundo é o mesmo nearest rank do exemplo anterior, aplicado à amostra inteira. Um percentil guarda a posição e joga fora a distribuição que o produziu, e nenhuma conta feita depois recupera o que foi descartado, nem a ponderada pelo volume. O caminho é agregar histogramas compatíveis e calcular o percentil depois.
Com um histograma clássico no Prometheus, uma consulta ilustrativa seria:
checkout-p99.promql
histogram_quantile(
	0.99,
	sum by (le) (
		rate(http_request_duration_seconds_bucket{
			job="checkout",
			route="/checkout",
			method="POST"
		}[5m])
	)
)Aqui, sum by (le) combina os buckets das instâncias antes de histogram_quantile estimar o P99. O resultado está em segundos: 0.6 representa 600 ms. A consulta pressupõe buckets compatíveis; nomes e labels são exemplos, não uma configuração universal.
A mesma cautela vale no tempo: a média dos P99 de cada minuto não representa o P99 do dia.
Confira quem entrou na medição
Misturar um health check de dois milissegundos com uma exportação de oito segundos cria um número difícil de usar para avaliar qualquer uma das experiências. Separe operações com expectativas diferentes. Também distinga a duração de uma tentativa interna da operação completa, que pode incluir retries.
O ponto de observação importa. Uma duração registrada pelo servidor não cobre necessariamente o tempo de rede visto por quem o chamou. A documentação do , por exemplo, diferencia justamente essas perspectivas.
Há ainda três cuidados que evitam diagnósticos errados:
- Poucas amostras: com cem observações, P99.9 vira o máximo pelo nearest rank. Isso não equivale a conhecer bem o comportamento raro do serviço.
- Falhas rápidas: responder com erro pode reduzir a latência e piorar o produto. Separe sucesso e falha e acompanhe a duração de cada um.
- Traces selecionados: uma amostra concentrada em erros ou chamadas lentas não representa automaticamente a distribuição de todas as requisições. Use-a para investigar, não como substituta silenciosa da população medida.
O teste pode aliviar a carga justamente quando o sistema piora
Se o gerador só envia a próxima requisição depois da resposta anterior, uma lentidão reduz a taxa de novas chegadas. Esse efeito pode esconder parte do problema e é conhecido como coordinated omission.
Quando o objetivo é simular chegadas independentes, use um modelo de carga que preserve essa característica. O modelo fechado não é sempre errado; ele responde a outra hipótese de uso.
A documentação do explica essa diferença entre modelos abertos e fechados. O teste precisa representar a demanda que você quer avaliar, não apenas produzir um percentil bonito.
Com a medição em ordem, o percentil passa a servir para mais do que observar: dá para prometer.
Do P99 ao SLO: transforme latência em objetivo
SLO, ou Service Level Objective, é uma meta para a qualidade do serviço. Para acompanhar seu cumprimento, uma proporção de eventos bons sobre eventos elegíveis facilita a contagem do que atendeu ou não à expectativa.
Em vez de deixar apenas “P99 abaixo de 300 ms” no documento, podemos tornar a promessa explícita:
Em uma janela móvel de 28 dias, pelo menos 99% das requisições elegíveis de checkout devem terminar com sucesso em até 300 ms, medidos na entrada da API.
A elegibilidade precisa ser definida. Neste exemplo, erros internos e timeouts contam como eventos ruins; não são removidos para melhorar o resultado.
O SLI, indicador usado para acompanhar a meta, é a proporção entre requisições boas e elegíveis. Voltando às mil requisições sintéticas, todas bem-sucedidas, 950 terminaram em até 300 ms:
Requisições boas
Requisições elegíveis
SLI observado
950
1.000
95%
Requisições boas
950
÷
Requisições elegíveis
1.000
=
SLI observado
95%
Nesse intervalo, atingimos 95%, não a meta de 99%. Para avaliar o SLO de 28 dias, precisamos das contagens da janela inteira, não da média dos percentis de cada intervalo.
A parcela tolerada de eventos ruins é o error budget, ou orçamento de erro. Um objetivo de 99% reserva 1%. Alertas podem considerar a velocidade de consumo desse orçamento, em vez de acionar alguém por qualquer oscilação curta do P99.
Os papéis se complementam: percentis ajudam a entender a distribuição; a proporção sob um limite ajuda a avaliar a promessa feita ao usuário. O limite de 300 ms aqui é didático, não uma recomendação universal.
A meta avisa quando o serviço saiu da linha. Ela não diz por quê, e é essa a pergunta que sobra.
Como investigar um aumento do P99
P99 alto é um sintoma, não um diagnóstico. O ponto de partida é um painel que reúna P50, P95/P99, volume, erros e saturação (o quanto da capacidade finita já está em uso: CPU, memória, conexões do pool), tudo com os mesmos filtros e intervalo.
A investigação pode seguir quatro movimentos:
- Localize a mudança. Ela começou após um deploy? Atingiu todas as rotas ou apenas o checkout? O volume também mudou? Compare recortes equivalentes.
- Veja quanto da distribuição mudou. P50 estável com P99 maior sugere começar pela parcela lenta. Se ambos subiram, investigue também uma degradação mais ampla. São pistas, não provas.
- Abra chamadas daquela faixa. Um trace, o registro do percurso de uma execução, mostra onde ela gastou tempo. Ferramentas como o X-Ray permitem selecionar uma faixa de latência e consultar os traces correspondentes.
- Teste a hipótese e compare novamente. Relacione a espera observada com métricas de banco, filas, pools ou runtime. Depois da mudança, confira cauda, erros e carga, não apenas a média.
Suponha que um trace do checkout revele 600 ms esperando uma conexão e 20 ms executando SQL. Nessa execução, o maior tempo observado está antes da query.
Isso orienta a próxima pergunta: por que as conexões permanecem ocupadas? Transações longas? Dependência externa dentro da transação? Concorrência acima da capacidade prevista?
Aumentar o pool sem responder pode apenas transferir mais trabalho simultâneo para o banco.
O percentil ajudou a encontrar a faixa problemática. O trace localizou a espera. A correção depende de confirmar o mecanismo que a produziu.
Teste seu entendimento
Antes de fechar, cinco perguntas sobre o que separa um percentil bem lido de um número bonito no painel:
Questão1/5
Naquela amostra de mil requisições, as dez mais lentas deixam de levar dois segundos e passam a levar dez. O que acontece com o P99 e com a média?
Conclusão
A média do checkout não estava errada. Ela respondia a uma pergunta: quanto tempo leva uma requisição, em geral? O suporte tinha feito outra: por que tem gente esperando? Duas perguntas, um número só no painel.
P50, P95 e P99 mostram pedaços diferentes da mesma distribuição, e nenhum deles significa muita coisa se você não souber quem entrou na conta, em que janela, somado de que jeito e o que aconteceu com quem falhou. Juntar percentil no painel nunca foi o objetivo. O objetivo é descobrir quem está esperando, se isso importa e por onde começar a procurar.
Abra o endpoint que mais recebe reclamação no seu sistema e ponha a média ao lado do P50, do P99, do volume e dos erros, tudo no mesmo intervalo. Depois abra uma chamada da faixa lenta e veja onde ela gastou o tempo.
É ali que o número vira uma decisão de engenharia.
Recomendados
As fontes por trás da cauda, da medição e do SLO deste artigo.